In partnership with

Hallo, ich bin Medien-Innovationsjournalistin Ulrike Langer und du liest News Maschinen. Falls dir jemand diesen wöchentlichen Newsletter weitergeleitet hat, kannst Du ihn ganz einfach selbst abonnieren und keine Ausgabe mehr verpassen.
Ich bin seit heute zurück von meinem dreiwöchigen Roadtrip mit vielen Erlebnissen und wilden Tieren - von Elchen mitten auf einem Wanderweg in über 3000 Meter Höhe in den Rocky Mountains in Colorado bis zu Bären auf einem Campingplatz in Nordkalifornien. Keine Klapperschlangen.
Kurz vor meiner Abreise habe ich mit Katya Gorchinskaya über ihre neue Journalismus KI-Datenbank J•Index gesprochen. Enjoy the read!
Dieser Text wurde inzwischen an einigen Stellen korrigiert und präzisiert (siehe Anmerkung am Ende).

Katya Gorchinskaya hat J•Index als kostenfreie Resource für die Medienbranche konzipiert. Für eine spätere Ausbaustufe plant sie eventuell tiefergehende zahlungspflichtige Features.
Katya Gorchinskayas Datenbank J·Index hat 3.326 verifizierte Fälle von KI-Einsatz in Nachrichtenmedien aus mehr als 130 Ländern dokumentiert, zurückreichend bis 2012. Zwei Zahlen darin sollten Dir dabei helfen, Behauptungen auf KI-Konferenzpanels der Medienbranche richtig einzuordnen. Erstens: Nur 35 dieser Fälle – rund ein Prozent – stammen von Medienunternehmen, die ihr Business rund um KI neu organisiert haben. Zweitens: Gerade einmal 348 Fälle, etwa jeder zehnte, berühren überhaupt kommerzielle Funktionen oder Monetarisierung. Der Rest sind redaktionelle Tools.
Falls Du in Eurem Unternehmen die KI-Strategie verantwortest und vermutest, dass alle anderen weiter sind als Ihr es seid: Ihre Daten sprechen dagegen. Diese Newsletter-Ausgabe zeigt, was die Datenbank verrät, wie sie gebaut ist und welche Erkenntnisse Du kostenlos aus ihr ziehen kannst.
Wer diese Datenbank gebaut hat – und warum
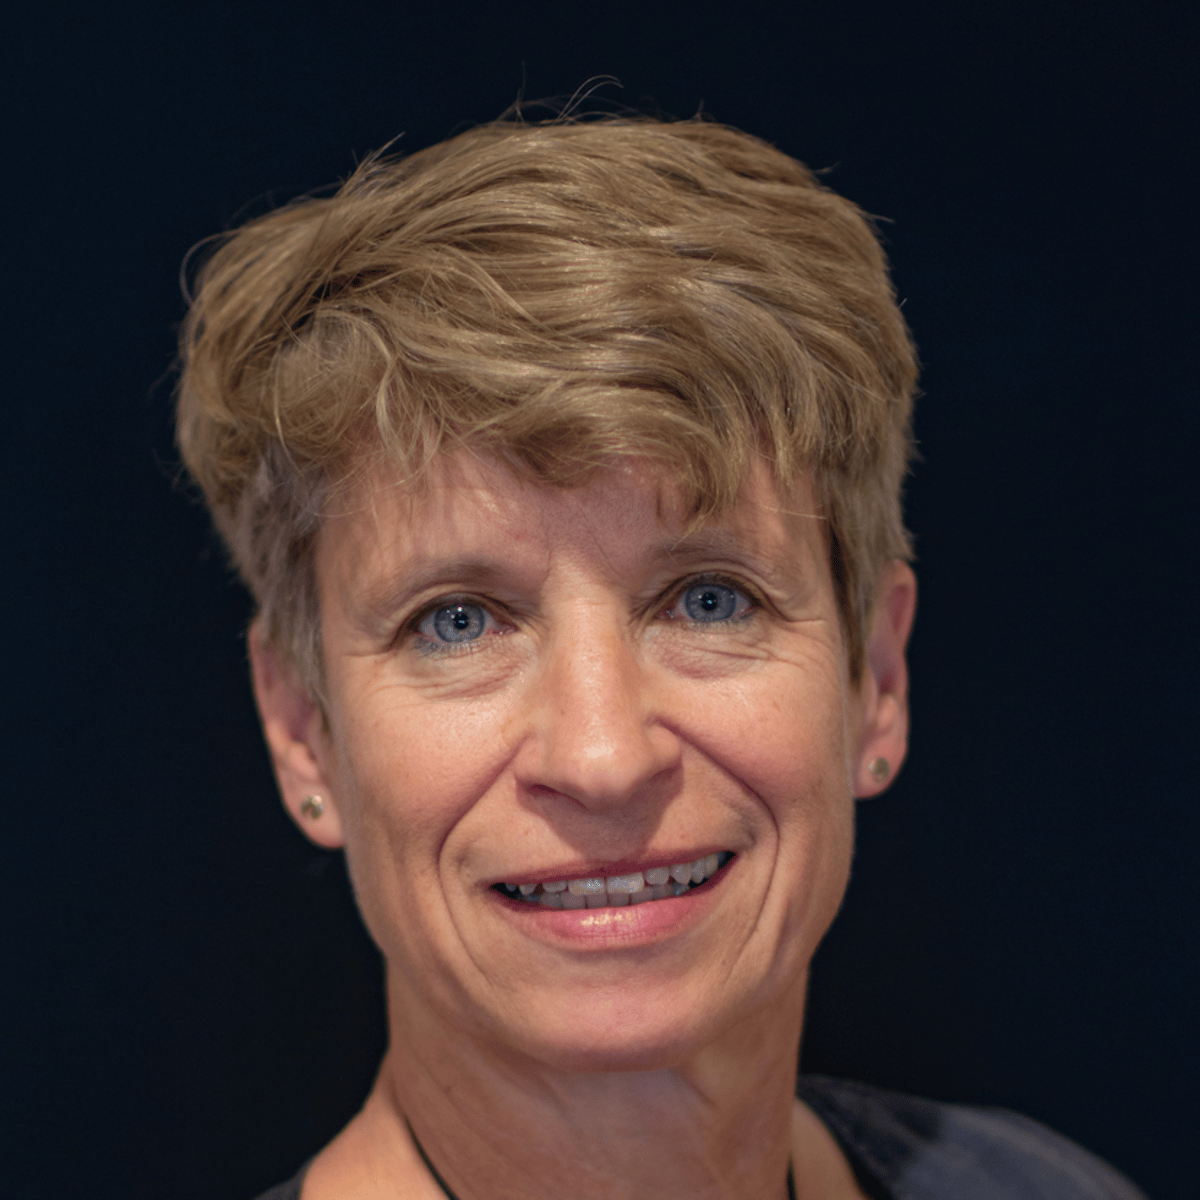
Gorchinskaya ist eine in der Ukraine geborene, in Spanien lebende Strategie- und Medienberaterin und frühere Journalistin. „I'm the leadership, strategy, technology girl“, erzählte sie mir in unserem Gespräch Mitte August. J·Index ist als Nebenprodukt davon entstanden. Im vergangenen Herbst schrieb sie einen Beitrag für das Reuters Institute und argumentierte darin, dass KI-Assistenten ihren Nutzern „Factslop“ servieren werden, während Newsrooms ihren Klick-Traffic verlieren. Leser fanden das deprimierend und baten um eine Fortsetzung: Was sollen Medienunternehmen dagegen tun?
Als dieser Strategie-Text zu etwa 90 Prozent fertig war, merkte sie, dass sie nur mit Anekdoten argumentierte – und suchte nach Daten, um ihre eigene Hypothese zu überprüfen, wie Newsrooms KI einführen. Gesammelt existierten diese Daten nirgends, also begann sie im Januar, sie selbst zusammenzutragen. Der fertige Text erschien im April bei WAN-IFRA, gestützt auf eine frühe Version des Datensatzes – und die Datenbank wuchs danach einfach weiter. Ende Juni ging das öffentliche Dashboard live.
Seit dem Start ist die Datenbank von 2.127 auf heute über 3.300 Case Studies gewachsen – und sie bleibt bewusst sauber strukturiert. Jeder Fall ist eine Zeile in einer einzigen Master-Tabelle mit 20 strukturierten Feldern – Organisation, Land, Funktion, Tech-Stack, Geldgeber, Reifegrad und Quellenlink. Jedes Feld akzeptiert nur festgelegte Begriffe, keinen Freitext. Case Studies kommen über ihre eigene Recherche herein und über Claude-Code-Sweeps, die sie gezielt auf Lücken ansetzt: „Wenn ich sehe, dass es in einer Region oder einem bestimmten Tool-Typ zu wenige Fälle gibt, richte ich die Sweeps genau darauf.“
Seit Juni liefert zusätzlich eine automatisierte Ebene zu, die rund 20 Fachmedien- und Branchenquellen abfragt. Ungeprüft kommt nichts hinein: „Ich checke buchstäblich jeden Sweep von Hand“, sagt sie. Wo ein Feld nicht offengelegt, sondern erschlossen ist – Finanzierungsquellen zum Beispiel –, deklariert die Methodik-Notiz diese Annahme. Was als KI zählt, entscheidet die OECD-Definition – deshalb reicht der Index ein Jahrzehnt vor ChatGPT zurück.
Ihre Aufnahmeschwelle ist radikal niedrig, und das ist eine bewusste Design-Entscheidung: „Ein Fall entsteht buchstäblich schon, wenn ein einzelner Journalist oder ein Newsroom ein Tool einsetzt.“ Eine einzelne Reporterin, die ein Transkriptions-Tool übernimmt, bildet die unterste Sprosse dessen, was Gorchinskaya als fünfstufige Reifegrad-Leiter kartiert – vom bloßen Zugang bis zur kompletten Neuorganisation.
Werbung
Join Fin, Anthropic, and Clay at Pioneer on October 7th

Pioneer, the summit where CX leaders redefine what’s possible, is on October 7th.
Join leaders from Fin, Anthropic, and Clay for an insightful conversation on the state of AI transformation.
You’ll discover how some of the most innovative minds in CX have transformed their organizations, learn how they think about CX, and hear how they're planning for what's next.
Join the conversation in San Francisco, or tune in virtually.
Über Stufe 3 der KI-Reifegrad-Leiter kommen wenige hinaus
Wenn man sich anschaut, wie sich die 3.326 Fälle über diese fünf Stufen verteilen, wird sichtbar, wo das Gros der Branche wird steht. Von allen Fällen mit Reifegrad-Bewertung liegen 337 auf Stufe 1, Zugang: Das Tool existiert, das Team darf es nutzen, nichts läuft regulär in Produktion. Die Masse steht auf Stufe 2, Einführung: 1.749 Fälle – mehr als die Hälfte des gesamten Index. Auf Stufe 3, Kompetenz, entfallen 841 Fälle, auf Stufe 4, veränderte Arbeitsweisen, 364. Und nur 35 Organisationen weltweit stehen auf Stufe fünf, wo KI Geschäftsmodelle selbst neu organisiert.
Auch eine zweite Sorge – dass KI Journalisten ersetzt – findet in den Daten wenig Rückhalt: In 69 Prozent der dokumentierten Fälle behält ein Mensch die volle Kontrolle über das Ergebnis. Das Bild über 3.326 Datenpunkte hinweg ist eindeutig: Unterstützung ist fast überall, Transformation fast nirgends.
Für die Strategiedebatte in Eurem Unternehmen heißt das praktisch: Wenn Ihr Euch an dem messt, was Wettbewerber auf Konferenzbühnen verkünden, stuft Ihr Euch zu niedrig ein. Messt Euch lieber daran, wie die 3.326 dokumentierten Fälle den realen Einsatz im Alltag aufzeigen – Stufe 2 ist die Norm.

Ein sehr nützliches Segment der Datenbank: Man kann nachschauen, wer welches Open-Source Tool für welchen Zweck einsetzt. Die Tools sind verlinkt.
Monetarisierung ist nur einer von zehn Fällen – und eine zweite Datenbank bestätigt den Befund
Unter den 3.326 Fällen dominiert die redaktionelle Produktion mit 1.998 Einträgen (60 Prozent ), mit Content-Produktion und Schreibassistenz als den zwei größten Funktionen. Dem stehen nur 348 Fälle aus dem Bereich Monetarisierung gegenüber (rund zehn Prozent).
Diese Zahl landet nah an einem Befund aus anderer Quelle. Im August habe ich Sergei Yakupovs Datenbank AI For Newsroom befragt und unter 1.047 erfassten Initiativen 77 zur Monetarisierung gefunden – 7,4 Prozent. Seine Aufnahmeregeln sind strenger bei der Nutzungstiefe – einzelne Tool-Nutzungen zählen dort nicht –, dafür breiter im Zuschnitt: Anders als Gorchinskayas rein journalistische Taxonomie lässt seine Datenbank auch Fälle außerhalb von Newsrooms zu.
Zwei Datenbanken kommen unabhängig voneinander zum gleichen Schluss: Geld verdienen ist das dünnste Segment der KI-Aktivität in Newsrooms. Das gleiche Missverhältnis steckt auch in Gorchinskayas handverlesener Open-Source-Auswahl: Von den 26 wiederverwendbaren Open-Source-Newsroom-Tools, sind 22 redaktionell. Genau drei betreffen Monetarisierung: Denník Ns Leser-Erlösplattform REMP und ihr Churn-Vorhersagemodul Pythia sowie der Anzeigenakquise-Agent der Seattle Times.
Ein ukrainisches Nonprofit mit 25 Leuten rangiert vor der Financial Times
Einen aktuellen Befund aus der Datenbank zog Gorchinskaya im August im Newsletter des Spiegel-KI-Chefs Ole Reissmann: 90 Prozent der synthetischen Nachrichtensprecher mit eigenem Namen, die Medienunternehmen weltweit eingeführt haben, sind weiblich. Medienunternehmen, argumentiert sie, wiederholen damit genau die Verzerrungen, die sie den KI-Modellherstellern vorwerfen.
Meine Lieblingsrubrik in der Datenbank ist “Oddities & Outliers” – handverlesene Fälle, die aus dem Muster fallen. Der auffälligste: Texty.org.ua, ein unabhängiges ukrainisches Nonprofit mit rund zwei Dutzend Mitarbeitern, steht mit 15 dokumentierten KI-Implementierungen im Index – mehr als die Financial Times (13), der Guardian (12) oder die Süddeutsche Zeitung (10), gleichauf mit dem Wall Street Journal. Nur Reuters, die New York Times, die BBC, die Nachrichtenagentur AP und die Washington Post rangieren höher. Doch das sind international operierende Mega-Unternehmen.
Und Textys Arbeit ist anspruchsvoll: Dazu gehören ein feinjustiertes Vision-Modell, das zerstörte Gebäude auf 300.000 Satellitenbild-Kacheln gefunden hat, eine Gesichtserkennungs-Pipeline, um nach Russland verschleppte ukrainische Kinder aufzuspüren, und eine Prüfung von 27 lokal betriebenen Open-Weight-Sprachmodellen: Wie sprechen sie über die Ukraine?
Im Juli wiederholte das Team seine eigene Recherche von 2018 zum illegalen Bernstein-Abbau mit einem aktuellen Geodaten-Modell und veröffentlichte das Ergebnis: Was einst sechs Monate dauerte, braucht nur noch Stunden.
Interessant: Newsrooms, die ihre alten KI-Methoden an neuen messen, gibt es in diesem Index fast gar nicht. Texty hingegen veröffentlicht auch seine Fehlschläge, darunter einen Clickbait-Klassifikator, der nie funktioniert hat.
Der Krieg prägt mehrere der ukrainischen Einträge. Gwara Media, ein kleiner Newsroom in Charkiw, baute den Faktencheck-Bot Perevirka zu Beginn der großangelegten Invasion, weil die Redaktion in Verifizierungsanfragen ihrer Leser ertrank – bis zu 5.000 pro Tag in der Spitze. Der Kyiv Independent baute sein Audience- und Abo-Modell unter Kriegsbedingungen – eine Case Study, die ich hier im Juni analysiert habe.
Gorchinskaya, die ukrainische Quellen im Original lesen kann, widersprach meiner Vermutung, ihr Hintergrund könnte die ukrainische Präsenz aufblähen: „Die Oddities-Auswahl beruht nicht darauf. Sie beruht auf wirklich neuen und ungewöhnlichen Dingen, die in genau diesen Newsrooms passieren.“

Das State of Adoption Dashboard zeigt, dass etwa ein Viertel aller Redaktionen (841) in der Datenbank eine Kompetenz-Stadium erreicht haben, aber nur 35 sind “AI-first” und haben ihre Prozesse und Geschäftsmodelle auf KI ausgerichtet.
Keine Förderung, keine API, kein Geschäftsmodell – vorerst
J·Index ist ein privates Projekt. Keine Institution finanziert die Datenbank, die unter einer Creative-Commons-Lizenz kostenlos verfügbar ist. Ob J·Index ein geplantes Business oder ein öffentliches Schaufenster für ihre Beratung ist, wollte sie nicht sagen: „Das erzähle ich Dir in einem halben Jahr.“ Eine bezahlpflichtige Ebene mit strategischen Insights ist denkbar – Leute stellen ihr ständig konkrete strategische Fragen, die die Daten beantworten können –, aber die dafür nötige Zahlungsinfrastruktur ist noch nicht zu rechtfertigen.
Die Skalierungsfrage lässt Gorchinskaya ebenso kalt. Ob die Datenbank 2000 oder 10.000 Fälle enthält, mache operativ „null Unterschied“, sagt sie. Der gesamte Datensatz passt noch immer in ein einziges KI-Kontextfenster. Der Zugang zu den Daten ist bewusst asymmetrisch angelegt. Einen CSV-Export des kompletten Datensatzes schließt Gorchinskaya aus – ein klares Nein, und dabei bleibt es.
Aber die Datenbank hat einen MCP-Server, der nach ihren Angaben seit dem Launch-Tag läuft. KI-Assistenten können damit den gesamten Bestand direkt abfragen: nach Land, Funktion, Organisation oder Stichwort, jede Antwort mit Quellenlink. Das Design sei „ein kleiner Burggraben" um ihre Daten – einer, der nur für Menschen gilt: KI-Agenten dürfen die Daten im Rahmen der Lizenz voll nutzen. Obendrein verspricht die Website eine „Ask Your Own Question"-Funktion für datengestützte Antworten. Die trägt weiterhin das Label „coming soon" – zu testen gibt es hier noch nichts.
Was Du heute schon mit dieser Datenbank anfangen kannst
Das Dashboard belohnt Stöbern – Abfragen sind ein Job für Deinen KI-Assistenten. Du kannst alle 3.326 Fälle nach Einsatzbereich, Region, Mediengröße und Land filtern, Dich von fünf Oberkategorien in 29 Funktionen hineinklicken und sehen, welche Tools Newsrooms für welche Aufgabe einsetzen – Transkription, Verifizierung, Personalisierung – und ob sie sie gekauft, selbst entwickelt oder als Open Source übernommen haben. Architektur-Blaupausen zeigen, wie verbreitete Tool-Typen wie Redaktionsassistenten und Leserfragen-Bots typischerweise gebaut sind. Die Open-Source-Liste verlinkt direkt auf 26 wiederverwendbare Code-Archive.
Und wenn Dich ein Fall interessiert: Jede Zeile trägt einen aktiven Quellenlink, was die Datenbank ebenso zum Recherche-Tool wie zum Strategie-Tool macht. Als Abonnent oder Abonnentin von News Maschinen bekommst Du bereits jede Woche eine Case Study (oder Analyse) – hier findest Du mehr als 3000 weitere Rechercheansätze.
Meine fünf Learnings:
Nutze die Reifegrad-Leiter vor Deinem nächsten Strategiemeeting. Ein Prozent der weltweit dokumentierten Fälle hat ein Geschäftsmodell um KI herum neu organisiert (Stufe 5). Wenn Euer Unternehmen auf Stufe 2 oder 3 steht, liegt Ihr nicht abgeschlagen zurück sondern im Mittelfeld.
Zwei unabhängige Datenbanken bestätigen jetzt die Monetarisierungs-Lücke. J·Index sagt rund zehn Prozent, AI For Newsroom sagt 7,4 Prozent. Auf Panels geht es um Erlöse; in Newsrooms entstehen redaktionelle Tools.
Kleine Redaktionen können an der Innovationsspitze stehen – mit Fokus. Texty implementiert mit zwei Dutzend Leuten mehr als fast jeder Medienriese, weil das Team sich harte, spezifische Probleme aussucht und alles veröffentlicht, auch die Fehlschläge.
Der Zugang läuft über KI-Agenten. Herunterladen kannst Du Gorchinskayas Daten nicht – das ist Absicht. Aber jeder KI-Assistent kann sie über ihren MCP-Server abfragen, wie bei Yakupovs Datenbank auch. Die Mauer ist für Menschen, nicht für Maschinen.
Verifizierung zählt mehr als die Größe. 3.326 Fälle zählen weniger als die Disziplin dahinter: Jeder Eintrag ist von Hand geprüft, jede Annahme deklariert, jede Zeile mit einer Quelle verlinkt. An diesem Standard solltest Du jede Behauptung über KI-Adoption messen.
Korrektur, 11. September:
In einer früheren Version dieses Textes hieß es, J·Index biete keine API, keinen CSV-Export und keinen MCP-Server an – basierend auf meinem Interview mit Gorchinskaya Mitte August. Beim Nein zum CSV-Export bleibt es, aber die Datenbank hat sehr wohl einen MCP-Server (jindex.ai/mcp), über den KI-Assistenten sie abfragen können – laut Gorchinskaya live seit dem Launch. Der Abschnitt zum Datenzugang und ein Learning wurden aktualisiert, außerdem unterscheidet der Vergleich mit AI For Newsroom die Aufnahmeregeln der beiden Datenbanken jetzt präziser.